Jev 置信度可信吗:从 0.89 翻车案例到阈值调参与降级设计
Jev 的 confidence 只反映概率分布形状,不是准确率保证。本文对照官方字段语义,拆解社区生产翻车案例(把握度 0.89 的错误建议、9 分钟阈值翻转),给出 unknown 选项、按损失分层阈值、决策留痕与降级设计的完整做法。
常见问题
Jev 返回的 confidence 是准确率吗?
给 Choice 加 unknown 选项有什么代价?
置信度阈值定多少合适?
Noul 答案有 confidence 字段吗?
Jev 发布一周内,社媒上出现了同一批关键词的反复出现:confidence bug、把握度 0.89 的建议是错的、9 分钟内阈值翻转。这些生产翻车案例指向同一个认知偏差——把 confidence 当准确率用。这篇把官方字段语义和社区踩坑案例对齐,给出能落地的校准与降级做法。案例数字全部是社区自述(文中有出处),字段语义以官方文档为准。
confidence 到底承诺了什么?
直接回答:它只承诺反映概率分布的形状,不承诺「选得对」。
官方 Confidence 概念页的表述很清楚:confidence 是从 probabilities 分布计算出来的统计量——分布集中在单一选项时接近 1,摊薄在多个选项时走低。它存在的意义是让你「不用自己做数学」就能设阈值,仅此而已。官方对模型层面的校准性主张是:Jev 经 RLCD 训练(Reinforcement Learning for Calibrated Decisions),目标是「置信度更高时准确率确实更高」——注意这是官方口径,且校准是模型层面的事,不等于你的业务分布里已经校准。
中文社区对边界的总结(lnxi269983,2026-09-26)和官方语义完全对得上:
格式符合约束,不代表选得对;有置信度,也不代表你的业务里已经校准。做错决策,仍然会造成真实损失。
三个字段的分工再强调一遍:choice 告诉你选了什么,probabilities 告诉你每个选项的概率分布,confidence 把分布形状折叠成一个数方便你设阈值。语义解释参见决策原语详解。另一个容易踩的细节:Noul 答案不带 confidence——是非判断的确定性由「是」概率本身承担。

Jev Ultrafast GitHub: How TypeSafe AI Makes Browser Agents Faster(含 RLCD 与 confidence 的工程解读,Alex Hitt)
为什么把握度 0.89 的建议也会错?
直接回答:因为高 confidence 只说明「分布集中」,而分布可以集中在一个错误答案上——尤其是选项清单没有给模型留「都不对」的出口时。
三个社区生产案例(全部为当事人自述,本站未复现,引用需带回原文核对):
| 案例 | 自述现象 | 当事人归因 | 出处 |
|---|---|---|---|
| 生产建议排序 | 被采纳与被拒绝的建议把握度只差 0.004;把握度最高的一条(0.89)是错的 | 案例细节见其长文《把握度 0.89 的建议,是错的:我们在生产环境用 Jev 踩过的 4 个坑》 | limitlessdeng,2026-09-25 |
| 交易决策 | 00:05 给标的打 0.44(拒绝开仓),00:13 同一标的打 0.7(开仓),9 分钟翻转 | 拒绝不留痕、输入无审计、被拒样本不入统计 | xbox_grok,2026-09-24 |
| 通用结论 | 「As of now you should not trust the confidence score」 | 分布被强行压缩到给定选项上,模型在「赌」 | florianhoenicke,2026-09-26 |
HN 上对「不会幻觉」宣传的困惑(seizethecheese)也是同一个机制:约束输出杜绝的是「格式错乱」,不是「选错」。错误选择会以完全合法的类型出现。
怎么给决策集留一个「不确定」出口?
直接回答:在选项清单里显式加一个 unknown(或 other)选项,让模型能把「都不对/信息不足」表达成概率,而不是被压着赌一个。
这是 florianhoenicke 那条 workaround 帖的核心建议(原文 2026-09-26,本站逐字核验):
If you are looking for a way to find out if Jev is gambling, then include the option “unknown”. It will help you to avoid misclassifications that are caused by Jev committing to a single possibility.
它不是野路子——官方 Choice 文档自己就建议:「当选项清单可能覆盖不了所有输入时,加一个 other 或 none of the above 选项,让模型可以说『其他都不符合』」(Choice 单问题最多 255 个选项)。官方 Confidence 页更是把话说到了根上:「如果一个智能系统(无论人还是机器)无法表达诚实的不确定性,它就无法被信任。」
写法上就是在 criteria 里加一项(完整请求结构见中文上手教程):
{
  "return_reason": {
    "type": "choice",
    "instructions": "What is the customer asking for?",
    "criteria": {
      "wrong_size": "Received a different size than ordered",
      "damaged": "Item arrived damaged",
      "other": "A return reason that fits none of the above",
      "unknown": "The ticket does not contain enough information to tell"
    }
  }
}然后按官方的读法用分布:unknown 概率显著、或最高两项咬得很紧时,走「问一句」而不是「猜一个」。florianhoenicke 用掷骰子实验演示了检验方法——给「我掷了骰子,点是四」这类陈述加 unknown 出口后,观察两类错误(事实缺失时硬猜、事实给出时不必要地弃权)是否都得到控制。
阈值该定多少?按误判损失分层,不拍同一个数
直接回答:阈值不是一个数字,是按动作风险分层的一组数字——这句是官方文档原文的意思:「A confidence threshold is not one number. Different actions within the same system should be gated at different levels depending on the consequences of getting it wrong.」
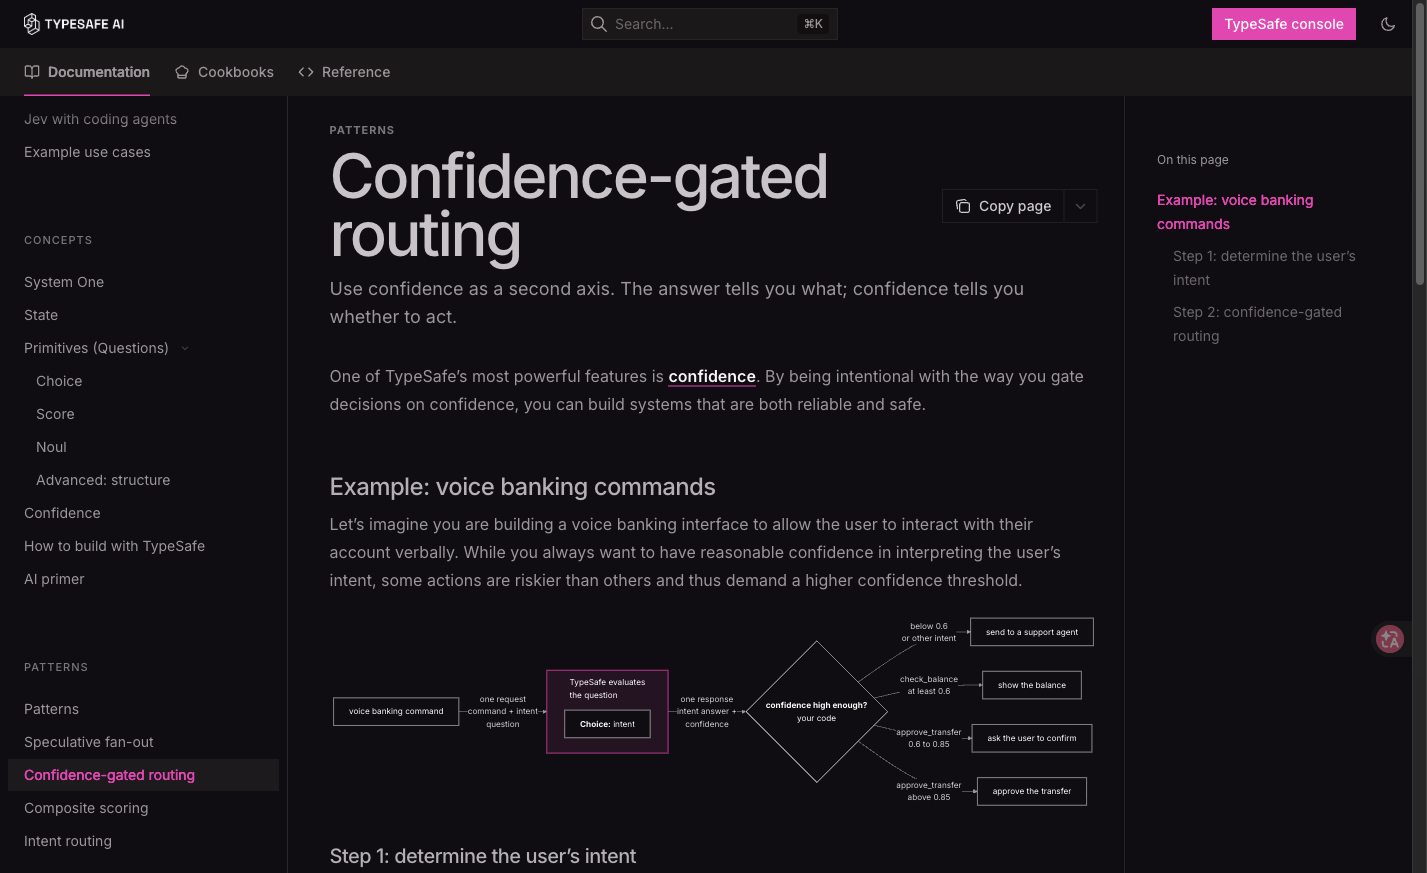
官方语音银行示例的分层的完整逻辑:
- 0.6 以下:无论什么动作,一律转人工——这个地板接住所有「模型自己也不确定」的情况;
- 查余额(低损失):0.6 就够——最坏结果不过是用户再听一遍余额;
- 批准转账(高损失):0.85 以上才自动执行;0.6–0.85 之间先向用户确认。
官方 Confidence 页给的三段式起点更好记:高置信度自动执行、中置信度谨慎处理(确认/标记/补充信息)、低置信度不动作。落代码就是官方示例的形状:
action = response.answers["intent"]

if action.confidence < 0.6:
    route_to_support_agent(account_id)      # 地板:模型不确定就交给人
elif action.choice == "approve_transfer" and action.confidence <= 0.85:
    ask_user_to_confirm(account_id)         # 高损失 + 中置信:先确认
elif action.choice == "approve_transfer":
    approve_transfer(account_id)            # 高损失 + 高置信:自动执行
你的业务里这组数字从哪来?从黄金集来:拿 30–50 条真实样本跑一遍,看不同阈值下「自动执行的错误率」和「转人工的量」的取舍——方法在客服分流实战里完整走过一遍。
翻车之后怎么复盘?留痕、回流、再校准
直接回答:把每一笔决策(输入、分布、置信度、实际结果)记下来,被拒绝的样本也回流进黄金集——xbox_grok 案例的三个归因(拒绝不留痕、输入无审计、被拒样本不入统计)恰好就是三件事的反面。
对照着改:
- 决策留痕:响应里的
model字段回报实际作答的版本 ID,和输入、分布一起落日志。这还牵出版本管理:官方明确建议——一旦你针对某个版本调好了阈值,钉死版本号(如jev-1.13.0)而不是跟jev-latest别名,别名会随新版本发布悄悄移动,你的阈值就失配了。 - 输入审计:state 里到底发了什么要有记录,否则「同一个标的 9 分钟打出两个分」时你无法回答「是输入变了还是模型变了」。
- 被拒样本回流:被阈值拦下转人工的样本,人工裁决后就是最好的新黄金集样本——它们正是模型分布咬得很紧的区域。
什么时候该放弃置信度,直接降级?
直接回答:三种情况不值得调阈值——问题本身不适配(数学计算、间接引用、对抗性内容,这些是官方 jaggedness 页承认的失败模式,算术放代码、生成放 LLM)、分布长期扁平(说明状态里没有足够信息,先补数据而不是压阈值)、误判损失不可接受(高副作用动作一律保留人工确认,置信度只是参考)。
官方给的低置信度出路是三条:转人工、请求澄清、回退到另一套系统——最后一條就是降级设计的接口位:Jev 判断不确定时,把同一份 state 交给小模型或 LLM 走慢速链路。组合方式的选型见Jev vs LLM:组合架构选型。
置信度是这套体系里最值得花时间的一个字段:它不保证你选得对,但它诚实地告诉你模型什么时候在赌——前提是你给过它说「不知道」的出口。
相关文章
concepts
Jev 是不是只是分类器:「不会幻觉」的边界、延迟质疑与已知局限
Jev 发布后最大的两场争论:它是不是只是分类器、「不会幻觉」要不要打星号。本文对照官方发布文、jaggedness 已知失败模式与社区质疑逐条核对:哪些质疑成立、哪些是口径差、哪些官方自己已经承认,并给出场景级的适用判决。
guides
Jev 上手排错指南:429 限流、waitlist 卡审与 OpenRouter 替代路径
Jev 上手阶段的故障排查手册:waitlist 没过审先查确认邮件与登录状态、429 限流要看双维度与 retry-after、请求体要显式构造并留 other 出口;另核对 OpenRouter Jev Router 网关路径与直连 API 的差异。故障案例来自社区一手报告,限额数字以官方文档为准。
concepts
Choice / Score / Noul:三种决策原语怎么选、怎么写
Jev 的所有请求都由三种问题类型构成:Choice(封闭选项二选一)、Score(有序量表定位)、Noul(是非概率)。本文用官方文档的请求/响应结构逐一拆解字段含义、概率与置信度怎么读,以及最容易踩的三个契约设计错误。
这篇文章有帮助吗?
感谢反馈!